
पहचानें कि आपको किस प्रतिनिधित्व की आवश्यकता है
इस कार्य के लिए आवश्यक आउटपुट स्पष्ट रूप से IPA है: [ʃɪŋ]। स्मार्ट IPA खोलें, सुझावों को बंद करें और एक खाली [] मचान टाइप करें। फिर कीबोर्ड से SAMPA अंग्रेज़ी चुनें और जांचें कि स्मार्ट IPA सुझाव फिर से बंद हैं। कोष्ठक के अंदर कैरट रखें। यह शाब्दिक विराम चिह्न को विशेष लेआउट की रीमैप की गई कुंजियों से अलग रखता है।
वास्तविक शोध सामग्री का उपयोग करने से पहले, निर्धारित करें कि क्या इसका स्रोत IPA, SAMPA या कोई अन्य ASCII अंकन है। वे लेबल डेटा से संबंधित हैं, न कि केवल इसे दर्ज करने के लिए उपयोग किए जाने वाले कीबोर्ड से। किसी भी एन्कोडेड स्रोत की एक मूल प्रति रखें। एक कीबोर्ड शॉर्टकट जो एक बार सही दिखने वाला प्रतीक देता है, यह सबूत नहीं है कि पूरे स्रोत को उसी नियम के साथ डिकोड किया जा सकता है।
सीधे पहला ग्लाइफ़ चुनें
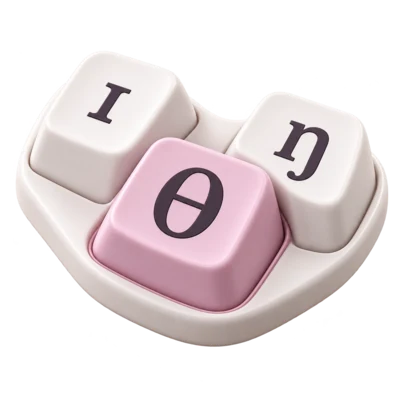
अनशिफ्ट s स्थिति पर दृश्य ʃ कुंजी पर क्लिक करें। एडिटर में अब ब्रैकेट के बीच एक ध्वन्यात्मक वर्ण है। उद्धृत UCL SAMPA तालिका में, अपरकेस S संबंधित ध्वनि को दर्शाता है और लोअरकेस s का मान अलग है। इस पृष्ठ की लोअरकेस स्थिति एक स्थानीय इनपुट शॉर्टकट है, इसलिए दोनों नियमों को समान नहीं बताया जाना चाहिए।
ASCII प्रतिलेखन प्रणाली में केस और अनुक्रम सार्थक हो सकते हैं। यहाँ संरक्षित लेआउट उन सम्मेलनों के लिए सामान्य पार्सर की आपूर्ति नहीं करता है। इसकी शिफ्ट की गई परत विरल है, और कुछ आधार कुंजियाँ अनुपलब्ध हैं। क्लिक करने से पहले बड़े ग्लिफ़ की जाँच करना, प्रकाशित SAMPA स्ट्रिंग टाइप करने और यह आशा करने से अधिक विश्वसनीय है कि पेज का नाम रूपांतरण की गारंटी देता है।
आपूर्ति किए गए IPA अनुक्रम को समाप्त करें
i स्थिति पर ɪ और n स्थिति पर ŋ पर क्लिक करें, Shift और Alt Gr अभी भी बंद हैं। आपूर्ति किए गए कार्य के विरुद्ध [ʃɪŋ] पढ़ें। स्थानीय n कुंजी ŋ डालती है, जबकि UCL तालिका वेल्यर नासिका के लिए साधारण n और अपरकेस N के बीच अंतर करती है। यह इनपुट-स्थिति नोट्स को मानक SAMPA डेटा के विवरण से अलग रखने का एक और कारण है।
नमूना आपसे किसी शब्द की पहचान करने या अंग्रेजी लहजे का अनुमान लगाने के लिए नहीं कहता है। इसके वर्गाकार कोष्ठक एक योजनाबद्ध ध्वन्यात्मक अनुक्रम को चिह्नित करते हैं। यदि आपको वास्तविक शब्द प्रतिलेखन की आवश्यकता है, तो पहले इच्छित भाषा विविधता और स्रोत विश्लेषण प्राप्त करें। डायरेक्ट टाइपिंग वर्ण प्रविष्टि को हल करती है; यह निर्धारित नहीं कर सकती कि स्रोत में कौन सा स्वर वर्ग, तनाव पैटर्न या खंड अनुक्रम होना चाहिए।
IPA परिणाम को उसके स्रोत के साथ सहेजें
पाठ डाउनलोड करें चुनें और i2speak.txt को UTF-8 के रूप में खोलें। परिणाम की तुलना एडिटर से करें और क्रम में ʃ, ɪ और ŋ की पुष्टि करें। चेक किया गया डाउनलोड IPA वर्ण डेटा है। यदि आपके नोट्स ASCII स्रोत भी बनाए रखते हैं, तो बिना किसी स्पष्टीकरण के एक ही कॉलम में रखने के बजाय दोनों प्रस्तुतियों को स्पष्ट रूप से लेबल करें।
बड़े कॉर्पस के लिए, इसके प्रलेखित SAMPA संस्करण और भाषा सूची के लिए डिज़ाइन की गई रूपांतरण प्रक्रिया का उपयोग करें, फिर प्रतिनिधि आउटपुट की समीक्षा करें। जानबूझकर मैन्युअल प्रविष्टि या सुधार के लिए इस कीबोर्ड का उपयोग करें जहाँ इसके मैपिंग ज्ञात हैं। एडिटर में एक स्रोत स्ट्रिंग पेस्ट करने से शाब्दिक टेक्स्ट रह जाता है; यह पूर्ण ट्रांसक्रिप्शन डिकोडर को लागू नहीं करता है।
सही नोटेशन चुनें
कुछ सुधार या एक पूर्ण कॉर्पस?
एक दृश्य-कुंजी कार्यप्रवाह एक छोटे चेक किए गए संपादन के लिए उपयुक्त है। एक बड़े एन्कोडेड डेटासेट के लिए एक ज्ञात स्रोत सम्मेलन के साथ एक स्पष्ट, प्रतिलिपि प्रस्तुत करने योग्य रूपांतरण प्रक्रिया की आवश्यकता होती है, न कि अनुमानित कीबोर्ड शॉर्टकट की एक श्रृंखला की।
IPA और ASCII को अलग-अलग फ़ील्ड में रखें?
जब दोनों उपयोगी हों, तो स्पष्ट रूप से लेबल किए गए निरूपण और एक नोट रखें कि एक को दूसरे से कैसे तैयार किया गया था। यह बाद में समीक्षा को संभव बनाता है बिना यह अनुमान लगाए कि कोई वर्ण ध्वनि प्रतीक है या इनपुट कोड।
मैपिंग का ईमानदारी से वर्णन करें
समझाएं कि स्थानीय s स्थिति ʃ कैसे डाल सकती है, भले ही एक प्रकाशित SAMPA तालिका अपरकेस S का उपयोग करती हो।
मॉडल उत्तर के साथ तुलना करें
उत्तर को एक इंटरफ़ेस मैपिंग को एक एन्कोडेड प्रतिलेखन प्रणाली से अलग करना चाहिए। इसे यह दावा नहीं करना चाहिए कि SAMPA केस अप्रासंगिक है।
सामान्य प्रश्न
क्या मैं इसे स्वचालित रूप से परिवर्तित करने के लिए SAMPA स्ट्रिंग पेस्ट कर सकता हूँ?
नहीं। पेस्ट करना शाब्दिक पाठ सम्मिलित करता है। इस लेआउट की व्यक्तिगत-कुंजी मैपिंग संपूर्ण-स्ट्रिंग SAMPA या X-SAMPA पार्सर नहीं है।
कुछ सामान्य अक्षर कुंजियाँ खाली क्यों हैं?
लेगसी लेआउट उन स्थितियों पर केवल चयनित प्रतीकों को परिभाषित करता है। एक अनुपलब्ध कुंजी सामान्य-अक्षर फॉलबैक या पूर्ण शिफ्टेड वर्णमाला का वादा नहीं करती है।
क्या अंग्रेजी लेबल SAMPA वेरिएंट के बीच अंतर को हल करता है?
नहीं। स्रोत द्वारा उपयोग की जाने वाली सटीक परंपरा और भाषा सूची की जाँच करें। केवल लेआउट नाम बाहरी डेटा को डिकोड करने के लिए विनिर्देश नहीं है।
स्रोत और आगे का अध्ययन
- यूनिवर्सिटी कॉलेज लंदन: JSRU और SAMPA
सार्थक केस अंतर और बहु-वर्ण ASCII कोड दिखाने वाली एक प्राथमिक विश्वविद्यालय तालिका।
- इंटरनेशनल फोनेटिक एसोसिएशन: इंटरैक्टिव चार्ट
कार्य में चयनित IPA प्रतीकों की ध्वन्यात्मक पहचान।
- Unicode: IPA एक्सटेंशन
ʃ और ɪ सहित प्रतीकों के लिए एन्कोडेड वर्ण पहचान, चुने गए कीबोर्ड शॉर्टकट से स्वतंत्र।
इसे अभ्यास में लाएं
उदाहरण आज़माने के लिए SAMPA अंग्रेज़ी खोलें, फिर विषय के अभ्यास अभ्यासों के साथ जारी रखें।
अभ्यास गाइड को एक्सप्लोर करें